
Мережеві та розподілені файлові системи на Linux: чого ми навчилися на власних помилках
Перш ніж зупинитися на сучасному об'єктному сховищі для LightUpOn.Cloud, ми витратили чимало часу на оцінювання традиційних мережевих і розподілених файлових систем на Linux. Дослідження виявило повторювані структурні проблеми, через які ці рішення потребують значного обслуговування й ризиковані для промислових середовищ, що працюють із великими обсягами або критично важливими для бізнесу даними.
Постійні виклики мережевих файлових систем
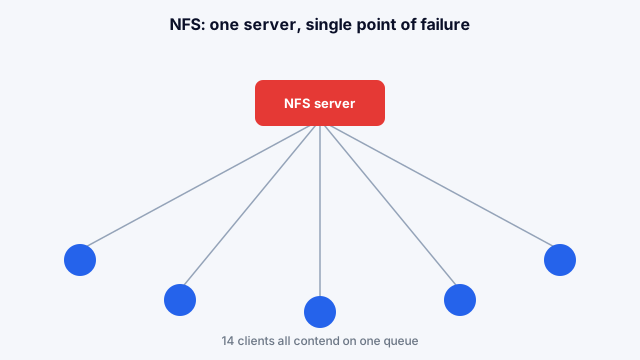
Мережеві файлові системи на кшталт NFS проєктувалися для порівняно невеликих і середніх інсталяцій із передбачуваним навантаженням. На практиці вони часто стають єдиною точкою відмови. Коли розділ заповнюється, адміністратори змушені виконувати марудну роботу з перенесення томів між серверами та їх повторного монтування по всій інфраструктурі. Масштабованість залишається обмеженою, а продуктивність може непередбачувано погіршуватися за інтенсивного одночасного доступу.
GlusterFS та розподілені альтернативи
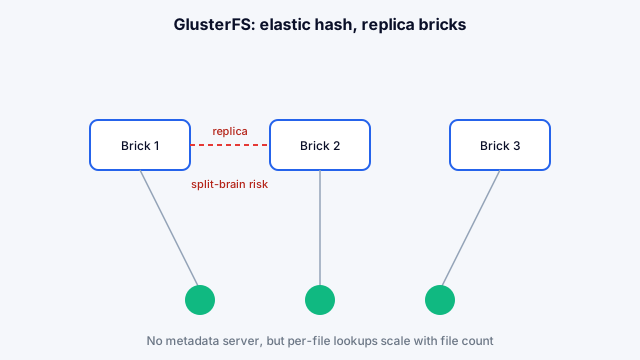
GlusterFS обіцяла майже необмежене масштабоване сховище завдяки своїй архітектурі на основі трансляторів. Насправді ж вона супроводжувалася суттєвими операційними труднощами. Вона погано давала раду великій кількості дрібних файлів (перелік каталогу лише з 3500 файлами міг тривати 20 секунд), потребувала точної синхронізації за NTP і страждала від єдиної точки відмови у своєму сервері імен. Тонке налаштування продуктивності було сумнозвісно складним — оптимізації під одне навантаження часто нищили інше.
Інші розподілені варіанти демонстрували схожі закономірності. OpenAFS пропонувала цікаві можливості реплікації, але була складною в адмініструванні. GFS2 та OCFS2 потребували виділеного спільного сховища й мали власні обмеження щодо блокувань, підтримки ACL та готовності до промислового використання. PVFS (розроблена для HPC) жертвувала відмовостійкістю заради продуктивності, тоді як Ceph — попри вдосконалення впродовж років — досі вимагає ретельного налаштування розмірів блоків і може поступатися у продуктивності в загальних сценаріях.
Тягар обслуговування
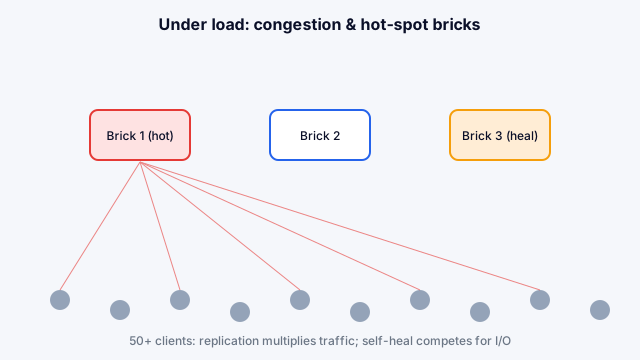
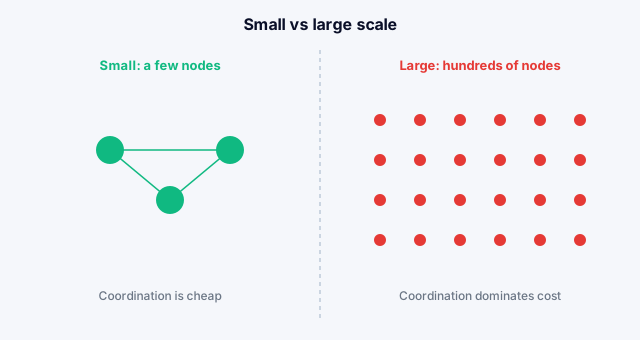
Майже в усіх мережевих і кластерних файлових системах, які ми тестували, простежувалася спільна риса: високі операційні витрати. Адміністратори витрачають непропорційно багато часу на керування міграціями томів, балансування навантаження, розв'язання ситуацій split-brain і відновлення після відмов вузлів. Багато рішень запроваджують єдині точки відмови або потребують складних латок ядра та постійного обслуговування, що просто не масштабується економічно зі зростанням обсягів даних.
Чому ми обрали об'єктне сховище
Цей досвід привів нас до архітектур об'єктного сховища. Системи на кшталт MinIO (сумісні з S3) усувають ключові слабкості традиційних мережевих файлових систем, забезпечуючи вбудований розподіл, передбачувану відмовостійкість і надійні моделі узгодженості без адміністративної складності керування томами та точками монтування файлової системи. Протокол S3 також гарантує незалежність від постачальника та прості шляхи міграції.
Для LightUpOn.Cloud ця основа забезпечує надійну високопродуктивну синхронізацію, водночас уникаючи крихкості й тягаря обслуговування, що часто супроводжують розгортання мережевих файлових систем у промислових середовищах.